01 Eerst en vooral

Beheer van de levenscyclus van producten (PLM)

Product Lifecycle Management (PLM) is een strategische benadering voor het ontwikkelen, beheren en verbeteren van producten, van concept tot verkoop, een manier om met de verschillende fasen van de levenscyclus van een product om te gaan. Het kan echter ook een stuk software (of systeem) zijn dat productieorganisaties en Engineering-to-Order (ETO) -bedrijven helpt om deze verschillende fasen efficiënt te doorlopen.

Door bestaande procedures en processen te combineren met individuele expertise en innovatieve technologie, biedt PLM-software zoals Siemens Teamcenter een raamwerk dat de productkwaliteit verbetert, de kosten verlaagt en de time-to-market versnelt. Software voor productlevenscyclusbeheer biedt één platform voor alle productgegevens en gerelateerde processen. Deze enkele bron van waarheid maakt het makkelijker voor belanghebbenden om de meest actuele informatie te vinden, waardoor ze sneller en efficiënter de juiste beslissingen kunnen nemen.
02 De fases van PLM

Wat, wanneer en waarom?

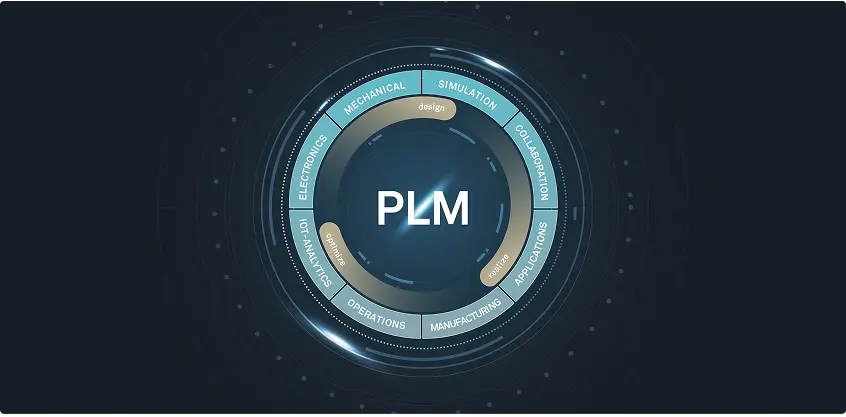
Vanuit een productie- en ETO-perspectief kan productlevenscyclusbeheer worden onderverdeeld in vijf hoofdfasen: concept, ontwerp en engineering, fabricage, inbedrijfstelling en ontmanteling.
{{tweede-eerst}}

‍

{{tweede seconde}}

‍

{{tweede derde}}

‍

{{tweede-vierde}}

‍

{{tweede-vijfde}}

‍

03 De voordelen van PLM

Hoe kan PLM helpen?

De voordelen van Product Lifecycle Management voor de productie zijn niet alleen gekoppeld aan transparantie en tijdregistratie. Duidelijke protocollen, mogelijk gemaakt door uitgebreide PLM-software zoals Siemens Teamcenter, vergroten de kans op het creëren van producten van betere kwaliteit, minder fouten en grotere kostenbesparingen dankzij efficiëntere productieprocessen.

Kortom, PLM-software is cruciaal voor zowel aangepaste ETO-aanvragen als massaproducten.

‍

{{derde-eerst}}

‍

{{derde seconde}}

‍

{{derde derde}}

‍

{{derde vierde}}

‍

{{derde-vijfde}}

‍

04 De belangrijkste componenten van PLM-software

Optimalisatie van de PLM-waardeketen

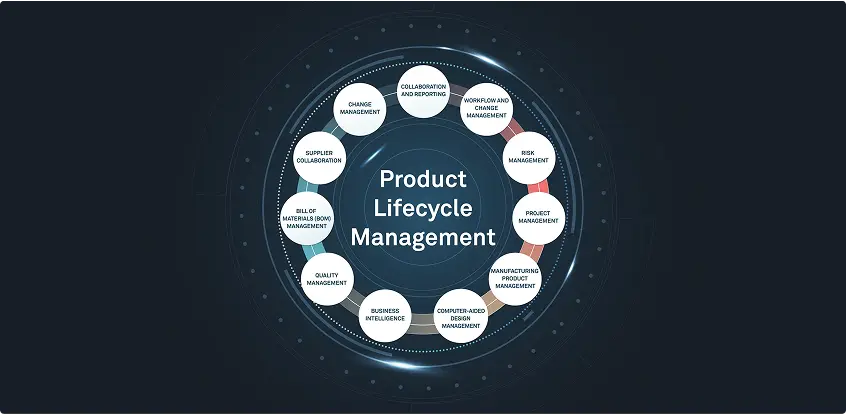
PLM-software stroomlijnt de manier waarop verschillende productiebedrijven en specifieke belanghebbenden toegang hebben tot gegevens. Dit wordt gedaan door tools en functies te integreren om het algehele beheer van een product te optimaliseren. Sommige tools, zoals CAD-software, worden intensief gebruikt in specifieke fasen, terwijl belangrijke componenten zoals documentbeheer de ruggengraat vormen van het totale aanbod van een PLM-systeem.

Siemens Teamcenter biedt een groot aantal tools en componenten die PLM een vanzelfsprekendheid maken voor fabrikanten die hun bedrijfsprocessen willen opschalen en optimaliseren zonder de oorspronkelijke visie voor het merk en de producten uit het oog te verliezen.

‍

{{vierde-eerst}}

‍

{{vierde seconde}}

‍

{{vierde derde}}

‍

{{vierde-vierde}}

‍

{{vierde-vijfde}}

‍

{{vierde-zesde}}

‍

{{vierde-achtste}}

‍

{{vierde-zevende}}

‍

05 Een PLM-implementatiepartner kiezen

Stel jezelf de juiste vragen

Het kiezen van een PLM-partner is de eerste stap naar meer efficiëntie, vlottere processen en beter gegevensbeheer. Om ervoor te zorgen dat aan de behoeften van uw bedrijf nu en in de toekomst wordt voldaan, is het echter de moeite waard om een aantal zaken te overwegen.

‍

{{vijfde-eerst}}

‍

{{vijfde seconde}}

‍

{{vijfde-derde}}

‍

{{vijfde-vierde}}

‍

{{vijfde-vijfde}}

‍

{{vijfde-zesde}}

‍

06 Digitale transformatie met CLEVR

Levenscyclusbeheer van producten in actie

Siemens Teamcenter is een uitgebreide PLM-softwaresuite die uitgebreide mogelijkheden biedt voor het beheren van productgegevens en -processen gedurende de gehele levenscyclus van het product.

We hebben ervoor gekozen om samen te werken met Siemens vanwege de verzameling tools en integraties van Teamcenter en vanwege de algehele bruikbaarheid.

Nel Hydrogen is onlangs een samenwerking aangegaan met CLEVR om zijn productontwikkelingsmogelijkheden aanzienlijk te verbeteren. Door gebruik te maken van Siemens Teamcenter implementeert CLEVR een uitgebreide PLM-oplossing die het gegevensbeheer stroomlijnt en technische processen helpt automatiseren. De samenwerking is aan de gang, met het oog op de uitbreiding van de reikwijdte van dit initiële project.

Onze expertise op het gebied van digitale transformatie en PLM is wat ons onderscheidt van andere oplossingspartners. We combineren uitgebreide branchekennis met expertise op het gebied van digitalisering om op maat gemaakte Siemens Teamcenter-oplossingen te implementeren die de levenscyclusprocessen van producten automatiseren en stroomlijnen.

Zelfs als uw bedrijf schaalt en zich aanpast aan nieuwe uitdagingen, blijven uw processen flexibel en robuust. Laat CLEVR u begeleiden bij de gewaagde beslissingen van vandaag voor meer gemoedsrust.

Ontwerp en techniek

Deze fase omvat praktische taken die een concept tot leven brengen; gedetailleerde productontwerpen, specificaties en prototypes zijn de naam van het spel. Tools zoals CAD-systemen helpen ontwerpers ideeën te visualiseren, waardoor ingenieurs prototypes kunnen maken.

Afdelingen voor kwaliteitsborging en engineering in grotere productieorganisaties gebruiken prototypes om ervoor te zorgen dat een product voldoet aan de ontwerp- en prestatie-eisen vóór massaproductie. Feedback uit tests benadrukt de verfijningen die nodig zijn voor de validatie.

ETO-bedrijven gebruiken in deze fase vaak virtuele prototypes, modellen en simulaties. Door te veel fysieke iteraties te vermijden, blijven de kosten laag voor bedrijven die minder kunnen profiteren van schaalvoordelen.

Conceptie

Tijdens de ideevormingsfase helpen concurrentieanalyses marktkloven en onvervulde behoeften van klanten te identificeren. Deze informatie wordt gebruikt om het product te conceptualiseren en zo een solide basis te leggen voor de volgende PLM-fasen en besluitvormingsprocessen.

Autofabrikanten kunnen bijvoorbeeld een concurrentieanalyse uitvoeren om hiaten in de markt voor elektrische vrachtwagens te identificeren, waarbij ze een nieuw model bedenken dat voldoet aan specifieke behoeften op het gebied van stedelijke bezorgdiensten.

Fabricage

Vanuit het oogpunt van massaproductie begint deze fase met een gevalideerd, marktklaar product dat het resultaat is van iteratieve feedbackrondes tijdens de ontwikkeling. Zodra het productieproces is opgezet, is het tijd om op te schalen. Het plannen, uitvoeren en monitoren van het geschaalde productieproces omvat supply chain management en kwaliteitscontrole.

ETO-bedrijven hebben meestal één productieproces en maar één kans om een bestelling goed te krijgen. Daarom is deze fase sterk afhankelijk van nauwkeurige informatie van het ontwerp en de engineering, mogelijk gemaakt door efficiënte PLM-software die de juiste informatie op het juiste moment naar de juiste mensen stuurt.

Inbedrijfstelling

Voor massafabrikanten bestaat deze fase voornamelijk uit het op de markt brengen van het product, distributie, verkoop en ondersteuning. Succesvolle productlanceringen vereisen dat deze aspecten vanaf het begin op elkaar zijn afgestemd.

In een ETO-context omvat de inbedrijfstelling het aanpassen van de levering, installatie en ondersteuning van een product. Het succesvol implementeren van op maat gemaakte producten vereist zorgvuldige logistieke coördinatie, gedetailleerde installatieprocedures en klantenondersteuning op maat.

Het beheren van de producteffectiviteit — het aanschaffen van reserveonderdelen en documentatie voor een specifieke productversie — is hier ook cruciaal.

PLM-software helpt deze complexe processen te beheren door nauwkeurige, actuele informatie te verstrekken aan alle belanghebbenden. In een ETO-machineproject zorgt PLM er bijvoorbeeld voor dat technische details, installatiehandleidingen en ondersteuningsdocumentatie allemaal op elkaar zijn afgestemd, waardoor een soepele overgang van productie naar installatie op locatie bij de klant en voortdurende ondersteuning mogelijk is.

Ontmanteling

Bij de ontmanteling van producten zijn productmanagers, personeel op het gebied van milieuvoorschriften en logistieke teams betrokken. Met pensioen gaan is niet alleen het stoppen van de productie: effectieve communicatie met klanten en leveranciers is cruciaal. Een technologiebedrijf moet mogelijk plannen om verouderde laptops weg te gooien, te recyclen of opnieuw te produceren, om ervoor te zorgen dat de resterende voorraad wordt verkocht of gebruikt voor reserveonderdelen. De juiste mensen precies laten weten hoe deze processen naar verwachting zullen verlopen, is bijna net zo belangrijk als de procedures zelf.

Voor ETO-bedrijven betekent ontmanteling een zorgvuldige planning van de uitfasering van op maat gemaakte producten en ervoor zorgen dat klanten gedurende het hele proces worden ondersteund.

Verbeterde productkwaliteit

PLM-software creëert één enkele bron van waarheid voor alle productgegevens, waardoor (bevoegde) afdelingen en belanghebbenden toegang hebben tot de laatste informatie. Dit uitgebreide gegevensbeheer vermindert fouten als gevolg van miscommunicatie of verouderde informatie.

PLM-software ondersteunt ook uitgebreide test- en validatieprocessen, waardoor fabrikanten problemen vroeg in de ontwikkelingscyclus kunnen identificeren.

Kortere time-to-market

PLM-software stroomlijnt de ontwikkelingsfase van een product door workflows automatiseren en de communicatie tussen teams verbeteren. Het verminderen van de tijd die aan administratie wordt besteed, versnelt de besluitvorming en helpt menselijke fouten te voorkomen die vaak worden veroorzaakt door repetitieve, handmatige taken.

Verbeterd gegevensbeheer en betere samenwerking verbeteren ook de efficiëntie van de eerdere levenscyclusfasen, wat leidt tot snellere marktintroducties.

Beter gegevensbeheer en betere samenwerking

Een gecentraliseerd PLM-systeem zorgt ervoor dat alle productgegevens gemakkelijk toegankelijk zijn voor degenen die ze nodig hebben, zoals marketeers die assets of campagneberichten aanmaken en personeel na verkoop dat trainingsmiddelen creëert voor klantenservicemedewerkers. Dit verbetert de nauwkeurigheid en consistentie van de gegevens, waardoor beter geïnformeerde besluitvorming mogelijk wordt. Met PLM-software kunnen en worden afdelingen aangemoedigd om informatie in realtime te delen, waardoor informatiesilo's worden verminderd en iedereen op één lijn blijft met de meest actuele informatie.

Kostenbesparingen gedurende de hele levenscyclus van het product

PLM-software helpt bedrijven inefficiënte praktijken te vermijden die bedrijfsprocessen vaak verstoppen. Dit helpt verlaag de kosten in verband met productontwikkeling, productie en onderhoud. Het ondersteunt ook een beter beheer van hulpbronnen en vermindert de noodzaak van dure herbewerkingen.

Dankzij een overzicht van het productieproces, inclusief het beheer en de controle van geautomatiseerde machines, kunnen bedrijven materiaalverspilling herkennen en manieren vinden om de productieschema's te optimaliseren. Dit verlaagt de productiekosten in verband met energieverbruik en grondstoffen, waardoor de impact van de bedrijfsactiviteiten op het milieu tot een minimum wordt beperkt. Siemens Teamcenter biedt een Calculator voor de CO2-voetafdruk om bedrijven te helpen bij het beoordelen van hun beslissingen bij het vinden van een evenwicht tussen milieueffecten, kostenreductie en het voldoen aan de eisen van klanten.

Integratie en connectiviteit

Siemens Teamcenter biedt uitgebreide integratiemogelijkheden met realtime gegevenstoegang voor betere samenwerking. Dit zorgt ervoor dat alle afdelingen en belanghebbenden gedurende de levenscyclus van het product op één lijn zitten. Dit is cruciaal voor ETO-fabrikanten en grotere organisaties die hun activiteiten willen stroomlijnen, de productkwaliteit willen handhaven en effectief willen opschalen.

Goede PLM-software moet naadloos kunnen worden geïntegreerd met verschillende bedrijfssystemen en ontwerptools, zodat gedurende de hele levenscyclus een samenhangend beheer van productgegevens wordt gegarandeerd. Dit betekent dat een naadloze informatiestroom moet worden gecreëerd door ERP-systemen (Enterprise Resource Planning), CAD-tools (Computer-Aided Design) en software voor documentbeheer met elkaar te verbinden.

Computerondersteund ontwerp (CAD)

CAD-software is essentieel voor het maken van nauwkeurige 2D- en 3D-modellen, zodat ingenieurs en ontwerpers productontwerpen kunnen visualiseren en itereren. In PLM integreert CAD ontwerpgegevens met andere levenscyclusprocessen, zodat alle ontwerpwijzigingen efficiënt worden bijgehouden en beheerd. Zoals u zich kunt voorstellen, is CAD-software sterk betrokken bij de conceptiefase van de levenscyclus van een product. Dat geldt ook voor productgegevensbeheer.

Beheer van productgegevens (PDM)

PDM centraliseert alle productgerelateerde gegevens—wat vaak verandert—het waarborgen van toegankelijkheid, nauwkeurigheid en beveiliging. Dit verbetert steevast de samenwerking en besluitvorming. Binnen PLM beheert PDM de levenscyclus van productgegevens, inclusief versiebeheer en toegangsrechten, zodat de meest recente informatie beschikbaar is voor de juiste mensen.

Materiaallijst (BOM)

Een stuklijst (BOM) bevat alle materialen, onderdelen en assemblageconfiguraties die nodig zijn om een product te vervaardigen, waardoor dit een belangrijk kenmerk van de ontwikkelingsfase is. Een stuklijst geeft de productstructuur weer in een hiërarchisch formaat dat de relatie tussen bepaalde componenten en assemblages duidelijk weergeeft. Afhankelijk van het product en de branche kan een stuklijst variëren van een eenvoudige structuur met één niveau tot een structuur met meerdere niveaus met specifieke fabricage-, engineering- en aanpassingsrichtlijnen.

Net als PDM-systemen volgen BOM-systemen veranderingen. Dit betekent dat alle aangevraagde wijzigingen in een stuklijst worden gedocumenteerd en ter goedkeuring worden verzonden. Een stuklijst kan ook hulpmiddelen bevatten om de kosten van materialen en componenten te analyseren. Een volledig en holistisch beeld van de kosten zal fabrikanten helpen bij het budgetteren van prognoses, algemeen kostenbeheer en rapportage.

Technisch veranderingsbeheer

Engineering Change Management is het volgen, controleren en goedkeuren van wijzigingen in productontwerpen en -processen. Tijdens de ontwikkelingsfase helpt Engineering Change Management belanghebbenden bij het beoordelen van de impact van voorgestelde wijzigingen op bestaande ontwerpen en processen. Het registreert ook wijzigingen, wat essentieel is voor de snelle ontwikkeling van een product dat vaak zoveel iteraties bevat, waarvan sommige mogelijk opnieuw moeten worden bekeken voor een nieuwe beoordeling.

Computerondersteunde productie (CAM)

CAM-software automatiseert de productie door CAD-modellen om te zetten in machine-instructies, waardoor de nauwkeurigheid en efficiëntie van de productie worden verbeterd. In PLM-software zorgt CAM ervoor dat productiegegevens consistent zijn met ontwerpgegevens, waardoor fouten worden verminderd en de overgangen tussen de ontwerp-, ontwikkelings- en productiefasen worden gestroomlijnd.

Beheer van de toeleveringsketen (SCM)

SCM-tools worden in de lancerings- en productiefase gebruikt om de goederen-, informatie- en financiële stromen met betrekking tot een product te beheren. In PLM zorgt SCM ervoor dat de activiteiten in de toeleveringsketen worden afgestemd op de productontwikkelings- en productieschema's, wat de efficiëntie verbetert en de kosten verlaagt.

Documentbeheer

Dit proces omvat het organiseren en beheren van alle documenten met betrekking tot de volledige levenscyclus van een product. Dit kan items omvatten die variëren van nalevingsdossiers tot productbrochures. Het is van cruciaal belang dat de benodigde documenten op gemakkelijk te vinden plaatsen zijn wanneer bedrijven nalevingsvragen van externe toezichthouders krijgen. Dit onderdeel is vaak een kenmerk van de eindfase waarin bedrijven proberen „de kringloop” van een bestaand product te sluiten en ervoor te zorgen dat het product is geproduceerd, gedistribueerd en stopgezet op een manier die voldoet aan een aantal (veranderende) voorschriften.

Naleving en regelgevingsbeheer

Het bijhouden van een database met de voorschriften en normen die van toepassing zijn op een product is van cruciaal belang om belanghebbenden op de hoogte te houden van de laatste ontwikkelingen op het gebied van regelgeving. Plotselinge veranderingen kunnen ertoe leiden dat producten niet aan de voorschriften voldoen, wat steevast leidt tot boetes en negatieve gevolgen kan hebben voor de publiciteit en het vertrouwen.

Dit belangrijke onderdeel biedt de tools om de naleving gedurende de hele levenscyclus van een product bij te houden, wat helpt bij het genereren van rapporten die nodig zijn voor indieningen van regelgeving. Audits kunnen vaak langdurig en zenuwslopend zijn voor bedrijven. Een geautomatiseerd proces om ervoor te zorgen dat producten voldoen aan de veiligheids- en kwaliteitsnormen kan dus helpen om verrassingen te voorkomen wanneer toezichthouders de documentatie doorzoeken.

Bieden ze een totaaloplossing?

Zorg ervoor dat de PLM-partner die u kiest de volledige levenscyclus van het product afhandelt. Degenen die slechts in bepaalde stadia verschijnen en reactief ondersteuning bieden, kunnen moeite hebben om de meest efficiënte resultaten voor uw bedrijf te behalen.

Zijn ze innovatief?

Het is goed om te overwegen hoe en of uw potentiële PLM-partner nieuwe technologie omarmt. Sommige beproefde methoden zijn allemaal goed en wel, maar partners die de kracht van low-code omarmen met nieuwe PLM-systemen zoals Siemens Teamcenter, kunnen de vonk geven die u nodig hebt om uw productprocessen naar een hoger niveau te tillen.

Hebben ze de juiste expertise?

Het is cruciaal om de expertise te verifiëren van degenen met wie u overweegt samen te werken. Hoe ervaren zijn ze als het gaat om het implementeren van PLM-oplossingen? Hebben ze de juiste connecties en partnerschappen met softwareleveranciers?

Zijn ze geschikt voor uw branche?

Zoek naar partners die inzicht bieden in de PLM-ruimte en uw specifieke branche.

Zoals elk goed PLM-systeem moet een implementatiepartner proactief zijn en waardering hebben voor de vooruitgang van digitale transformatietechnologie in alle sectoren.

Zullen ze je betrouwbare ondersteuning bieden?

Zorg ervoor dat uw PLM-partner ondersteuning biedt in elke fase van het implementatieproces, waarbij u zich richt op de behoeften van uw bedrijf met effectieve oplossingen die lang meegaan.

Hoe zit het met de toekomst?

Een goede PLM-implementatiepartner moet er niet alleen voor zorgen dat uw oplossingen en processen nu werken. Zorg ervoor dat uw partner een duidelijk, op maat gemaakt PLM-stappenplan opstelt dat jaren in de toekomst kijkt. Als ze zich concentreren op het hier en nu zonder rekening te houden met de mogelijke wendingen binnen uw bedrijf en branche, kunt u voor vervelende verrassingen komen te staan.
Related Stories

/Blog AI Mendix

Upgraden naar Mendix 11: Hoe Maia en mxcli je documentatie up-to-date houden

Published on Nov 04, 2026
min read
Blog
AI
Mendix

Vraag een willekeurige Mendix-ontwikkelaar wat hij liever doet: een nieuwe functie bouwen of een halve dag besteden aan het documenteren van de vorige, en je kent het antwoord al. Documentatie is misschien veel minder dankbaar dan programmeren, maar dat is niet de enige reden waarom het onderaan de backlog belandt.

Onder strakke deadlines en de druk om werkende code op te leveren, is documentatie meestal het eerste dat sneuvelt. Wat er wel wordt geschreven, is vaak informeel, lastig te volgen en snel verouderd. Hoe rommeliger de bestaande documentatie wordt, hoe minder nut ontwikkelaars erin zien om deze bij te werken, en de kloof wordt met elke release alleen maar groter.

Wat als documentatie zichzelf up-to-date zou kunnen houden, mee zou schalen met de applicatie en herleidbaar zou zijn naar elke wijziging? Voor veel teams zou dit meer veranderen dan alleen de dagelijkse ontwikkeling. Het zou veranderen hoe ze aankijken tegen een upgrade naar Mendix 11.


De verborgen kosten van ongedocumenteerde Mendix-apps

Veel Mendix-applicaties draaien al jaren in productie, sommige sinds Mendix 6 of 7, en veel daarvan zijn bedrijfskritisch. Ze upgraden naar Mendix 11 zou een logische stap moeten zijn. In plaats daarvan voelt het vaak als een sprong in het diepe.

Wanneer zoveel van wat de app doet zich alleen in de hoofden van mensen bevindt, kan niemand precies zeggen wat erin zit, wat er kapot zal gaan of hoe lang het duurt om daarachter te komen. Hierdoor staan teams voor drie dilemma's:

1. Nu upgraden, of blijven bouwen op oude grond?

Upgraden betekent de confrontatie aangaan met wat jaren aan wijzigingen hebben achtergelaten: verborgen workarounds, verouderde widgets en oude modules die niemand zich meer herinnert. Elke grote Mendix-versie stelt bovendien oudere widgets, modules en Java-versies buiten gebruik, dus een upgrade betekent vaak dat onderdelen van de app vervangen moeten worden, in plaats van ze alleen opnieuw te compileren. Maar blijven zitten waar je zit, betekent dat elke nieuwe functie wordt gebouwd op een fundament dat steeds verder achterop raakt, terwijl Mendix 11-mogelijkheden zoals Maia buiten bereik blijven.

2. Snel bewegen, of stabiliteit behouden?

De business wil nieuwe functies, meer gebruikers en nieuwe integraties. Zonder documentatie kan echter niemand de impact van een wijziging voorspellen, en zonder tests of een duidelijke beschrijving van hoe elk proces zich hoort te gedragen, kan niemand bevestigen dat alles daarna nog steeds werkt. Elke release wordt een afweging tussen snelheid en stabiliteit, en het opschalen van de app wordt elke keer moeilijker.

3. Investeren in de upgrade, of in nieuwe functies?

Als je de omvang van een upgrade niet kunt bepalen, kun je deze niet inschatten. Elk proces moet handmatig worden gecontroleerd, en de ervaren ontwikkelaars die de vragen konden beantwoorden, zijn misschien al vertrokken. Geconfronteerd met onduidelijke kosten en een werkende app, gaan budgetten naar zichtbare functies. De upgrade wordt steeds uitgesteld, en elk jaar dat het wacht, wordt het groter en duurder.


Haal het giswerk uit je Mendix 11-upgrade

Met Mendix 11 krijgen ontwikkelaars eindelijk wat legacy-apps al jaren missen: een helder overzicht van hun applicatie en de tools om deze met vertrouwen aan te passen.

1. Documenteer je Mendix-app voordat je iets wijzigt

De eerste stap uit het onbekende is een kaart. Maia, de AI-assistent die in Studio Pro is ingebouwd, en de Mendix CLI (mxcli) – een command-line tool van Mendix Labs waarmee coding agents zoals Claude Code of Codex met een Mendix-project kunnen werken – kunnen beide een applicatie inspecteren en de structuur blootleggen: modules, entiteiten, microflows, pagina's en de onderlinge afhankelijkheden.

Een agent kan die metadata omzetten in duidelijke documentatie over hoe de app werkt, zonder dat een ontwikkelaar dit handmatig hoeft te reverse-engineeren. mxcli voegt linting en best-practice rapporten toe die problemen en verouderde patronen markeren, waardoor technische schuld zichtbaar wordt nog voordat de migratie begint.

2. Snel bewegen zonder de controle te verliezen

Zodra de app gedocumenteerd is, is elke wijziging makkelijker te beoordelen. De impactanalyse van mxcli laat zien welke microflows, pagina's en entiteiten een wijziging zal raken voordat iemand deze doorvoert. Maar belangrijker nog: de documentatie raakt niet langer achterop.

Na elke wijziging, of het nu gaat om een nieuwe pagina, een nieuw attribuut of nieuwe bedrijfslogica, werkt de agent de documentatie bij als onderdeel van dezelfde taak, waarmee twee doelgroepen tegelijk worden bediend. Ontwikkelaars en zakelijke gebruikers lezen het om de app te begrijpen, en AI-agents gebruiken het om de volgende wijziging te sturen of om een assistent aan te sturen die nieuwe gebruikers helpt hun weg te vinden.

Omdat Maia en mxcli werken op basis van het Mendix-model in plaats van duizenden regels ruwe code, blijft de output eenvoudig te controleren.

3. Maak van je Mendix-upgrade een weloverwogen beslissing

Wanneer je inzicht hebt in wat er in de app zit, kun je de scope van de upgrade bepalen. Als je de scope kunt bepalen, kun je een inschatting maken, en verandert de discussie over het budget van een sprong in het diepe in een zakelijke beslissing.

Het platform waarnaar je upgradet is ook van belang. Met Mendix 11.12, de eerste Long-Term Support (LTS)-release van Mendix 11, krijgen teams een stabiele basis voor onderhoudbaarheid, beveiliging en schaalbaarheid op de lange termijn. De bijbehorende AI-ondersteunde tools zijn bovendien klaar voor bedrijfskritische productie-apps. Maia Plan zet een beschrijving om in epics en user stories, en Maia Make begint met de implementatie ervan, zodat de investering nog lang na de migratie rendement oplevert.

4. Leg de basis voor de agentic enterprise

Een applicatie die zichzelf documenteert, is ook klaar voor wat er komen gaat. Dit is precies wat bedrijven krijgen met Mendix in de context van enterprise-orkestratie.

Als onderdeel van Siemens Intelligence Center X (ICX), de industriële AI-orkestratiesoftware van Siemens, speelt Mendix – samen met Maia en mxcli – een belangrijke rol in het begrijpelijk maken van applicaties voor zowel agents als mensen. Met Mendix 11.12 kan een app fungeren als een MCP-server die zijn logica, data en workflows blootstelt aan andere AI-tools, en Mendix Workflows kan agents en mensen aansturen binnen een beheerde, controleerbare vertrouwenslaag, waarmee de basis wordt gelegd voor het hybride personeelsbestand dat mensen en AI-agents samenbrengt.


Zie mxcli in actie: één prompt, feature en documentatie klaar

In een recente demo liet Erick Souza, Sr. Mendix Developer & Mendix MVP bij CLEVR, zien hoe één enkele prompt een nieuwe feature kan bouwen en tegelijkertijd de documentatie kan bijwerken. Niemand hoeft dit achteraf nog handmatig te doen. Hier is wat hij liet zien, voor als je geen tijd hebt om de volledige video te bekijken.

Zou een developer deze wijzigingen handmatig kunnen doorvoeren? Natuurlijk, maar het zou langer duren. Hier gebeurt het automatisch, elke keer weer.


Upgrade met vertrouwen naar Mendix 11, beginnend bij je documentatie

Download mxcli van de Mendix Labs GitHub-pagina, plaats het in je projectmap en voer mxcli init uit. Binnen enkele minuten is je project klaar voor de coding agent van jouw keuze, of dat nu Claude Code, Codex of een andere tool is.

Vanaf dat moment is de eerste prompt de meest waardevolle: vraag de agent om te documenteren wat er al in je app staat, maak het bijwerken van de documentatie vervolgens onderdeel van elke prompt, en de kennis van je team groeit mee met de applicatie in plaats van erachteraan te lopen. Eén waarschuwing: mxcli is nog alfa-software en ontwikkelt zich snel, dus werk altijd aan een kopie van je project of onder versiebeheer, en controleer de wijzigingen van de agent zoals je het werk van een collega zou controleren.

Het resultaat is een fundament waar je op kunt bouwen. Een applicatie die je team begrijpt, een upgrade die je kunt plannen en een architectuur die klaar is voor de agentic enterprise.

Benieuwd hoe dit er voor jouw applicaties uit zou kunnen zien? Neem contact op met CLEVR om een demo aan te vragen.

november 4, 2026 5:08 PM
/Blog AI Intelligence Center X

Van datapunten naar beslissingen: Ontologieën en knowledge graphs bepalend voor het succes van de agentic enterprise

Published on Nov 06, 2026
min read
Blog
AI
Intelligence Center X

Elke agent in uw onderneming moet één vraag beantwoorden voordat deze in actie komt: waar kijk ik eigenlijk naar? Een taalmodel kan een record uit Teamcenter, SAP en uw MES lezen. Op zichzelf kan het niet weten dat het "onderdeel" in alle drie hetzelfde fysieke object is, dat dit onderdeel in een assemblage zit waarvoor een open technische wijziging geldt, en dat de garantieclaim van vorige week precies naar die assemblage verwijst.

Uw medewerkers weten dit door jarenlange ervaring. Agents hebben dit op schrift nodig. Dat vastgelegde begrip is een ontologie, en zodra deze wordt gevuld met live data, wordt het een knowledge graph. Samen vormen ze de minst opvallende en tegelijk meest bepalende laag van de agentic enterprise: de laag waardoor mensen en agents vanuit dezelfde werkelijkheid werken.

Deze blog legt uit wat ontologieën en knowledge graphs zijn, hoe ze werken, waar ze in uw architectuur passen, wat de voorgedefinieerde industriële ontologieën in Siemens Intelligence Center X maakbedrijven opleveren, en wat ervoor nodig is om er zelf een te bouwen.
‍

Weinig tijd? Hier een kort overzicht

  • Agents falen op context, niet op modellen. Gartner verwacht dat 60% van de AI-projecten zonder AI-ready data wordt stopgezet. Of een agent waarde creëert of incidenten veroorzaakt, hangt ervan af of hij begrijpt wat uw data betekent.
  • Een ontologie is het regelboek; een knowledge graph is de kaart die volgens dat regelboek is getekend. De graph verbindt elk onderdeel, elke wijziging en elke claim over uw systemen heen, zodat agents het pad van vraag naar antwoord kunnen volgen. Samen geven ze mensen en agents dezelfde definities, dezelfde regels en hetzelfde audittrail: de basis voor een hybride workforce die u kunt vertrouwen.
  • Houd de core clean en leg context erbovenop. Uw core systems blijven onaangeroerd aan de basis. De ontologie en knowledge graph liggen er direct boven als gedeelde contextlaag, met orkestratie en AI daarbovenop waar dat zinvol is.
  • Niet elke ontologielaag is gebouwd voor agents. Agents stellen vragen die niemand had voorzien, over veel systemen tegelijk. Graph Studio in Siemens Intelligence Center X is een schaalbaar graphplatform dat is ontworpen om zulke vragen op enterpriseschaal te beantwoorden, zonder prestatiegrenzen.
  • Bouw voort op bewezen branchekennis. U hoeft de maakindustrie niet vanaf nul te modelleren. Voorgedefinieerde industriële ontologieën en open standaarden beschrijven de digital thread al, van engineering-stuklijst tot garantieclaim. Uw domeinexperts maken ze eigen: ze koppelen records over systemen heen en bepalen hoe het model zich ontwikkelt. Begin met één systeemoverstijgende workflow en laat elke volgende use case daarop voortbouwen.
    ‍

Waarom agents vastlopen zonder context

Het model is zelden de bottleneck. De context waarmee het redeneert wel.

‍Gartner voorspelt dat organisaties tot en met 2026 60% van de AI-projecten zonder AI-ready data zullen stopzetten, en dat 63% van de organisaties de juiste datamanagementpraktijken voor AI mist of niet weet of ze die heeft. Specifiek voor agents verwacht Gartner dat eind 2027 meer dan 40% van de agentic-AI-projecten is stopgezet, vanwege oplopende kosten, onduidelijke bedrijfswaarde en ontoereikende risicobeheersing.

Het duidelijkste bewijs van wat context doet, komt uit een benchmark door data.world. Deze onderzoekers stelden GPT-4 zakelijke vragen over een bedrijfs-SQL-database uit de verzekeringssector. stelden GPT-4 zakelijke vragen over een SQL-database uit de verzekeringssector. Bij directe bevraging beantwoordde het model 16,7% van de vragen correct. Via een knowledge graph, gebouwd op een ontologie van dezelfde data, steeg de nauwkeurigheid naar 54,2%. Bij de moeilijkste vragen over de meest complexe schema’s scoorde directe SQL 0%, terwijl de route via de knowledge graph 36–39% haalde. Een vervolgstudie gebruikte de ontologie zelf om de queries van het model te controleren en te herstellen, en bracht de nauwkeurigheid naar 72%.

Hetzelfde model, dezelfde data. Het enige verschil was of de betekenis van de data expliciet was gemaakt. Voor een agent die niet alleen antwoordt maar ook handelt, bepaalt dat verschil of hij waarde creëert of incidenten veroorzaakt.

Waarom 72% een startpunt is, geen eindoordeel

Geen organisatie zou op basis van 72% moeten handelen, en geen goed ontworpen enterprisesysteem vraagt dat. De benchmark meet een taalmodel dat zonder vangrails zelf queries schrijft op open vragen. In productie veranderen drie dingen het beeld.

Ten eerste werkt de ontologie als controle, niet alleen als richtlijn. Queries die niet passen bij het model van de organisatie worden opgevangen en gecorrigeerd, of het systeem ziet af van een antwoord. Een bewust “ik weet het niet” is veilig. Een zelfverzekerd fout antwoord niet.

Ten tweede hangt de vereiste nauwkeurigheid af van de gevolgen. Bij het verkennen van een vraag is onzekerheid acceptabel. Bij het goedkeuren van een terugroepactie niet. Beslissingen met grote impact draaien op uitgewerkte regels en gevalideerde queries, met een menselijke goedkeuringsstap, terwijl open verkenning een ondersteunend hulpmiddel blijft.

Ten derde is elk antwoord herleidbaar. Welke data is gebruikt, welke query is uitgevoerd en wie de actie heeft goedgekeurd, wordt vastgelegd. Zo is een fout zichtbaar en te corrigeren, in plaats van verborgen.

De les uit het onderzoek is niet dat AI met ontologieën voor 72% betrouwbaar is. De les is dat het verankeren van AI in context de meest effectieve manier is om AI betrouwbaarder te maken, en eerlijk te laten zijn over waar de kennis ophoudt.
‍

Het regelboek en de kaart

Een ontologie is het regelboek; een knowledge graph is de kaart die door dat regelboek is getekend. De twee termen worden vaak door elkaar gebruikt, maar ze hebben een andere functie.

De ontologie is een formeel vocabulaire voor uw organisatie. Ze definieert welke soorten dingen er bestaan (een pomp, een productielijn, een technische wijziging, een leverancier), welke eigenschappen ze hebben, hoe ze met elkaar in verband mogen staan en welke regels gelden. Een pomp kan in een lijn zijn geïnstalleerd. Een technische wijziging raakt één of meer onderdelen. Een onderdeel mag niet worden vrijgegeven zonder goedgekeurd ontwerp. Zonder ontologie heeft u een plaatje van punten en lijnen. Met een ontologie weet het systeem wat elk punt is en kan het erover redeneren.

De knowledge graph is dat vocabulaire toegepast op uw echte data: pomp P-101, lijn 3, wijzigingsverzoek ECR-2291 en de miljoenen verbanden daartussen, continu bijgewerkt vanuit uw core systems.

Aspect Ontology Knowledge graph
What it is The schema of meaning: types, relationships, rules The instances: your actual assets, parts, orders and their links
Example “A Part is affected by an Engineering Change” “Part 4471-A is affected by ECR-2291”
Size Hundreds to a few thousand concepts Millions to billions of facts
Rate of change Slow, versioned, deliberately governed Continuous, synchronised with source systems
Owned by Domain experts and knowledge engineers Data pipelines, agents and the platform

Dit onderscheid is cruciaal voor de agentic enterprise. In de ontologie leggen mensen vast wat iets voor de organisatie betekent. In de graph lezen agents en applicaties die betekenis en handelen ze ernaar. Zit de ontologie goed, dan erft elke nieuwe agent dat begrip automatisch.
‍

Hoe een knowledge graph werkt

Een knowledge graph slaat elk feit op als triple: subject, relatie, object. Koppel genoeg triples aan elkaar en u krijgt een kaart waar mensen en agents doorheen kunnen lopen, in plaats van een datawarehouse dat ze met een dozijn moeizame joins moeten bevragen.

Triples. “Pomp P-101 is geïnstalleerd in lijn 3.” “Lijn 3 produceert product X.” “Product X bevat samenstelling 4471.” “Samenstelling 4471 heeft als eis max. 80 °C.” Elk ding is een node, elke relatie een edge. In de W3C-standaarden die de meeste enterprise graphs gebruiken, zijn dit RDF-triples, die met SPARQL worden bevraagd.

Traversal. Een vraag als “welke openstaande garantieclaims betreffen onderdelen die zijn geraakt door de technische wijzigingen van vorige maand?” loopt door PLM-, ERP- en servicedata. In een relationele wereld is dat een project. In een graph is het een pad: claim → serienummer → as-built-configuratie → onderdeel → wijziging. Agents zijn goed in het volgen van paden, zolang die paden bestaan en iets betekenen.

The ontology defines the path; the graph holds your data
Which engineering change touches this warranty claim? One path across service, ERP, MES and PLM data.
Ontology: the rulebook
Knowledge graph: the map
Warranty claim
Claim from last weekservice system
reported on
Product unit
Serial number of the unitERP
built as
As-built configuration
As-built recordMES
contains
Part
Part 4471-APLM and ERP, resolved as one
affects
Engineering change
ECR-2291PLM

Ontologie vs Knowledge graph · één pad van claim naar wijziging

De linkerkolom wordt één keer geschreven, door mensen. De rechterkolom wordt continu gevuld vanuit uw systemen. Een agent die de linkerkant begrijpt, vindt de rechterkant voor elke claim, in elke fabriek.

Inferentie. Omdat de ontologie regels bevat, kan de graph feiten afleiden die niemand heeft ingevoerd. Als elke samenstelling de compliance-eisen van haar onderdelen erft, markeert nieuwe regelgeving voor één materiaal direct elk product waarin dat materiaal zit.

Entity resolution. Het moeilijkste en minst zichtbare deel. “Pump_P101” in het onderhoudssysteem, “P-101” in het MES en “asset 4471-A” in het ERP moeten over miljoenen records heen als één object worden herkend. Gaat dat mis, dan redeneren agents vol vertrouwen over drie pompen die in werkelijkheid één zijn.

Gematerialiseerd of virtueel. Een graph kan data kopiëren naar een graph store, of de data laten waar ze staat en die ter plekke mappen. De fabriek van Bosch in Salzgitter koos een ontologie voor SMT-elektronicaproductie, gemapt op bestaande databases. Machinestoringen die per machine verschillend werden geregistreerd, werden samengebracht in één ontologieklasse, zodat engineers eindelijk appels met appels konden vergelijken.

Generatieve AI verankeren. Dezelfde structuur maakt retrieval voor taalmodellen scherper. LinkedIn bouwde een graaf op basis van historische klantenservicetickets in plaats van ze als losse tekst te behandelen. In productie verkortte het systeem de mediane doorlooptijd per issue met 28,6%. De les is direct toepasbaar op een service- of kwaliteitsorganisatie in de maakindustrie: structuur wint van een grotere stapel documenten.
‍

Waar het zit: een contextlaag bovenop een clean core

In het CLEVR Digital Renovation-principe vormen de core systems laag 1: ERP, PLM, CRM, MES en eigen applicaties, de bronsystemen die schoon en stabiel blijven. Bovenop die kern vormen de ontologie en knowledge graph laag 2: de semantische contextlaag waarmee elke laag daarboven redeneert. Orkestratie en intelligentie zitten in laag 3. In laag 4 ontmoeten mensen agents. De graph vervangt geen enkel bronsysteem; hij maakt de systemen voor elkaar begrijpelijk. Samen brengen de lagen het CLEVR-principe in de praktijk: houd de kern schoon, leg er een slim orkestratieplatform bovenop en versterk met AI waar dat zinvol is.

Keep the core clean, layer with a smart orchestration platform on top and amplify with AI where it makes sense.
CLEVR Digital Renovation layers mapped to Siemens Intelligence Center X
Layer 4 · Human-agent experience Approvals, exceptions and oversight: where people meet agents
Layer 3 · Orchestration and intelligence Mendix workflows, apps and agents · AI Studio models, applied where AI adds value
Layer 2 · Semantic context Graph Studio: connects the systems below, gives meaning to every layer above
Layer 1 · Core systems Systems of record: PLM, ERP, MES, CRM and in-house apps, kept clean and stable
Enterprise trust layer
Guardrails
Traceability
Audit

Vier lagen · een clean core als basis, semantische context erbovenop

Elke agent en app in de lagen daarboven haalt zijn betekenis uit dezelfde contextlaag, onder dezelfde vertrouwenslaag.

‍Siemens Intelligence Center X is volgens dezelfde logica opgebouwd, in vier stappen:

  1. Enterprisedata uit heterogene bronnen en dataplatforms.
  2. Context: een ontologielaag over de hele organisatie die elk datapunt betekenis geeft, geleverd door Graph Studio.
  3. Intelligentie: AI- en ML-modellen in AI Studio die leren van semantisch verrijkte data, die vrijwel realtime wordt ververst.
  4. Actie: applicaties, workflows en agents, gebouwd en georkestreerd op Mendix, allemaal geworteld in dezelfde context.

Over alle vier loopt een enterprisebrede vertrouwenslaag, met vangrails, herleidbaarheid en auditeerbaarheid voor zowel mensen als agents. De engine van Graph Studio is ontworpen voor tientallen tot honderden miljarden RDF-triples, in het geheugen, op schijf of gevirtualiseerd, en stelt de graph via MCP beschikbaar aan agents, zodat die over domeinen heen kunnen verkennen en bevragen.

De bredere markt beweegt dezelfde kant op. Microsoft maakte Fabric IQ, zijn op ontologie gebaseerde contextlaag voor agents, algemeen beschikbaar tijdens Build 2026 en stelt de ontologie via MCP open voor agents van andere leveranciers. Databricks en Google hebben hun semantische lagen in dezelfde richting ontwikkeld, en Palantir bouwt Foundry al jaren rond zijn Ontology. De vraag is niet langer of u een semantische laag voor agents nodig heeft, maar welke uw domein begrijpt en of die aansluit op de platforms die u al gebruikt. Intelligence Center X sluit aan op Microsoft Fabric, Snowflake, Databricks en Palantir in plaats van ermee te concurreren, en onderscheidt zich op twee punten: de diepgang van industriële betekenis die het vanaf dag één meebrengt, en een graph-architectuur die is gebouwd voor vragen die niemand had voorzien.
‍

Vier benaderingen van de ontologielaag

Niet elke ontologielaag is op dezelfde manier gebouwd. Kijk onder de motorkap en de markt valt uiteen in vier architectuurbenaderingen, elk geoptimaliseerd voor een andere taak.

Keep the core clean, layer with a smart orchestration platform on top and amplify with AI where it makes sense.
CLEVR Digital Renovation layers mapped to Siemens Intelligence Center X
Layer 4 · Human-agent experience Approvals, exceptions and oversight: where people meet agents
Layer 3 · Orchestration and intelligence Mendix workflows, apps and agents · AI Studio models, applied where AI adds value
Layer 2 · Semantic context Graph Studio: connects the systems below, gives meaning to every layer above
Layer 1 · Core systems Systems of record: PLM, ERP, MES, CRM and in-house apps, kept clean and stable
Enterprise trust layer
Guardrails
Traceability
Audit

De eerste drie zijn sterk in waarvoor ze zijn ontworpen. Een metadatalaag maakt dashboards en SQL-analyses consistent. Een objectlaag werkt goed wanneer de beslissingen vooraf bekend zijn en de objecten daarvoor kunnen worden gecureerd. Een transactionele graphdatabase is snel wanneer een vraag start bij een bekende node, zoals één klant of één asset.

Zo werken agents niet. Een hybride workforce stelt vragen waar niemand aan dacht toen het datamodel werd ontworpen: welke leveranciers, onderdelen, fabrieken en klanten worden geraakt als dit materiaal wordt beperkt, over alle productlijnen heen? Zo’n vraag heeft geen vast startpunt en doorkruist veel stappen en domeinen tegelijk. Op een metadata- of objectlaag betekent dat eerst nieuwe modellen of pipelines bouwen. Op een transactionele graphdatabase betekent het node voor node naar buiten werken, wat trager wordt naarmate de graph en de vraag groeien.

Van de vier benaderingen is alleen een schaalbaar graphplatform ontworpen voor die vraag. Graph Studio, de contextlaag van Intelligence Center X, draait op een massaal parallelle engine die de graph over het hele cluster verdeelt, zodat elke processorkern aan elke query meewerkt. De ontologie wordt automatisch gegenereerd vanuit de bronsystemen en gekoppeld, in plaats van per bron handmatig te worden opgesteld. Dat is het verschil tussen agents die de vragen beantwoorden waarop u had gerekend, en een agentische organisatie waarin mensen en agents elke vraag kunnen stellen, zonder tegen prestatiegrenzen aan te lopen.

Dat maakt de andere benaderingen niet overbodig. Intelligence Center X sluit aan op de dataplatforms die u al gebruikt, en voegt de contextlaag toe waarmee agents over al die platforms heen kunnen redeneren.
‍

Voorgedefinieerde industriële ontologieën: niet beginnen met een leeg blad

Een voorgedefinieerde industriële ontologie is een kant-en-klaar model van wat dingen in de maakindustrie betekenen, zodat u het uitbreidt in plaats van het zelf te bedenken. Hier onderscheidt Intelligence Center X zich van generieke semantische lagen.

Siemens levert Intelligence Center X met industriële ontologieën die branchekennis over de hele productlevenscyclus vastleggen. Out-of-the-box dekken ze de kernobjecten van de digital thread af: ontwerp, onderdeel, engineering-stuklijst (EBOM), technische wijziging, bill of process, servicestuklijst, garantieclaim, voorraad en IoT-tijdreeksen. Deze zijn live gekoppeld aan bronsystemen (PLM, ERP, CRM en eigen applicaties) en aan dataplatforms zoals Microsoft Fabric, Snowflake, Databricks en Palantir. Siemens omschrijft dit als data in context die “live, veilig, geconfigureerd en direct klaar voor gebruik” is.

Waarom dit ertoe doet, ziet u het best aan de stuklijst. Een engineering-stuklijst (EBOM) beschrijft wat het product is. Een productiestuklijst (MBOM) beschrijft hoe het wordt gemaakt. Een servicestuklijst beschrijft hoe het wordt onderhouden. In de meeste bedrijven staan deze stuklijsten in verschillende systemen, beheerd door verschillende teams, met verschillende identificaties. Een ontologie die al weet hoe een EBOM-item zich verhoudt tot zijn MBOM-tegenhanger, welke technische wijziging beide raakt en welke serviceonderdelen eruit voortvloeien, geeft agents de digital thread als navigeerbare structuur. Ze weerspiegelt bovendien decennia Siemens-ervaring met Teamcenter, Opcenter en het bredere Xcelerator-portfolio: kennis die duur is om vanaf nul opnieuw op te bouwen.

Siemens staat hierin niet alleen. Verschillende open initiatieven definiëren semantiek voor de maakindustrie, en een goede ontologiestrategie weet waar die passen:

Source What it covers Maintained by Where it helps
Siemens Intelligence Center X industrial ontologies Digital thread objects: EBOM, MBOM, change, bill of process, service BOM, warranty, inventory, IoT Siemens Digital Industries Software Fast start for Siemens-centric product lifecycles, live-connected to source systems
IOF Core Ontology Common manufacturing concepts (manufacturing process, assembly, material product, agent roles), plus domain modules for production planning, maintenance and biopharma Industrial Ontologies Foundry (OAGi), with NIST; MIT licence Shared vocabulary across companies and suppliers, built on the ISO/IEC 21838-2 top-level ontology
Asset Administration Shell (IEC 63278) Digital twin of an asset, with standard submodels such as Digital Nameplate, Technical Data and Handover Documentation Industrial Digital Twin Association (IDTA) Exchanging asset data across the supply chain, Manufacturing-X and Digital Product Passport

Deze initiatieven vullen elkaar aan in plaats van te concurreren. De IOF Core is zo ontworpen dat domeinontologieën onderling consistent blijven (IOF). De Asset Administration Shell structureert assetinformatie in submodellen waarvan de IDTA de templates publiceert (all-about-industries). Een voorgedefinieerde platformontologie brengt u het snelst naar productie; door die te mappen op open standaarden blijft u interoperabel met leveranciers en klanten.

Eén eerlijke kanttekening: geen enkele voorgedefinieerde ontologie kent uw bedrijf. Uw productfamilies, naamgevingsconventies, fabrieksspecifieke processen en eigen systemen moeten nog steeds worden gemodelleerd. Voorgedefinieerde ontologieën verschuiven het werk van bedenken naar uitbreiden, en dat is het verschil tussen maanden en weken.
‍

Wat er nodig is om een ontologie te bouwen

Ontologieontwerp is vakmanschap, geen configuratiescherm. Het slaagt wanneer het begint bij beslissingen en wordt gebouwd samen met de mensen die ze nemen. In onze ervaring volgt het zeven stappen:

  1. Begin bij de beslissingen, niet bij de data. Schrijf de vragen op die agents en mensen moeten kunnen beantwoorden: “Welke klanten worden geraakt als leverancier X uitvalt?” “Welke producten worden geraakt door deze wijziging?” Knowledge engineers noemen dit competency questions. Ze bepalen de scope en worden de testset.
  2. Hergebruik voordat u zelf bedenkt. Begin met een voorgedefinieerde industriële ontologie en open standaarden zoals de IOF Core of de Asset Administration Shell. Modelleer alleen wat uw bedrijf onderscheidt.
  3. Modelleer met domeinexperts aan tafel. EEngineers, planners en serviceverantwoordelijken weten wat een “release” of een “variant” echt betekent. Het integratiewerk bij Bosch liet zien dat de betrokkenheid van domeinexperts essentieel was voor zowel de ontologie als de mappings.
  4. Breng uw bronnen in kaart. Koppel velden in Teamcenter, SAP, het MES en uw eigen applicaties aan ontologieconcepten. Bepaal per bron of data naar de graph wordt gekopieerd of virtueel wordt bevraagd.
  5. Los entiteiten op. Bepaal welke records hetzelfde object in de echte wereld beschrijven, en houd die beslissingen uitlegbaar.
  6. Valideer aan de hand van de werkelijkheid. Draai de competency questions. Controleer de ontologie met een reasoner op logische consistentie. Laat agents de ontologie bevragen en kijk waar ze verkeerde paden nemen.
  7. Beheer en ontwikkel door. Versioneer de ontologie, wijs per domein eigenaren aan en houd de graph synchroon met zijn bronnen. Een graph die achterloopt op zijn bronsystemen bevat de data van gisteren, en een agent die daarop handelt, handelt op basis van het verleden.

Dit was vroeger de reden dat knowledge-graphprojecten een jaar nodig hadden voordat ze waarde opleverden. Automatisering verandert dat. Siemens positioneert automatische ontologiecreatie vanuit bronsystemen als manier om maandenlange ontologieontwikkeling overbodig te maken, en zet via MCP gekoppelde agents in om de knowledge graph zelf te helpen opbouwen en onderhouden. Onderzoek wijst dezelfde kant op: bij Boschmaakte het automatisch omvormen van een domeinontologie naar een slanker graphschema het genereren van knowledge graphs voor lasdata zeven tot acht keer sneller.

Automatisering versnelt stap 2 tot en met 5. Stap 1, 3 en 7 vervangt ze niet. Bepalen wat iets voor uw bedrijf betekent, en wie verantwoordelijk is voor die betekenis, blijft mensenwerk.
‍

Eén ontologie voor een hybride workforce

Een hybride workforce werkt alleen als mensen en agents dezelfde definities, dezelfde regels en dezelfde grenzen delen. Alle drie liggen vast in de ontologie.

Dezelfde definities. Als een planner en een planningsagent hetzelfde bedoelen met “beschikbare voorraad” of “vrijgegeven onderdeel”, leveren overdrachten geen fouten meer op. Zonder dat draagt elke agent stilletjes zijn eigen interpretatie mee in zijn prompt, en heeft u de silo’s die u wilde doorbreken opnieuw opgebouwd.

Dezelfde regels. Beleid dat is uitgedrukt in bedrijfsconcepten in plaats van databasetabellen, geldt voor iedereen. Intelligence Center X voegt beleidsgestuurde toegangscontrole toe aan de knowledge graph, op basis van kenmerken van zowel de gebruiker als de data, zodat dezelfde regel bepaalt wat een menselijke gebruiker en een agent mogen zien. Een agent voor leverancierskwaliteit ziet wat een leverancierskwaliteitsengineer mag zien, en niets meer.

Hetzelfde spoor. Omdat elke actie verwijst naar concepten in de graph, kan de vertrouwenslaag niet alleen vastleggen wat een agent deed, maar ook waarover hij redeneerde. Dat maakt beslissingen auditeerbaar en autonomie verdedigbaar.

Dit creëert ook nieuw werk voor mensen. In onze whitepaperreeks Digital Renovation beschreven we rollen als de Agent Supervisor en de Eval Owner. Voeg er één aan toe: de Ontology Steward, de domeinexpert die eigenaar is van wat een concept betekent en wijzigingen daarin goedkeurt. Onderzoekers noemen dit profiel de knowledge scientist. Hoe u het ook noemt: organisaties die deze rol overslaan, eindigen met een graph die niemand vertrouwt.
‍

Waar te beginnen: één proceslijn, niet de hele onderneming

U heeft geen ontologie voor de hele organisatie nodig voordat uw eerste agent live gaat. U heeft één waardevolle thread door uw systemen nodig, goed gemodelleerd, en een fundament dat meegroeit met elke volgende use case.

Kies een workflow die systemen overstijgt en vandaag pijn doet. Kwaliteit is een goede kandidaat. Siemens illustreert een typische lus van garantie naar engineering waarin klachttriage, onderzoek en rootcauseanalyse twee tot vier weken duren, en de oplossing zo’n acht. Die lus raakt garantieclaims, servicestuklijsten, as-built-configuraties, onderdelen en technische wijzigingen: precies de concepten die de voorgedefinieerde industriële ontologieën in Intelligence Center X al afdekken.

Van daaruit volgen we de CLEVR-aanpak die we bij elk agentisch programma toepassen: think big, start small, scale fast. Denk groot door de ontologie te ontwerpen als gedeeld fundament voor uw hele hybride workforce. Begin klein met één thread, uitgebreid vanuit een voorgedefinieerde ontologie in plaats van vanaf nul getekend. Schaal snel door elke nieuwe agent, app en workflow te laten hergebruiken wat de eerste de graph heeft geleerd.

Agents worden steeds slimmer. Of ze ook slimmer worden over uw bedrijf, hangt af van de laag eronder.

november 6, 2026 1:00 PM
/Blog Ruimtevaart en defensie Teamcenter

Digitale scheepsbouw: de bottleneck op de werf is niet het staal, maar de data

Published on Nov 02, 2026
min read
Blog
Ruimtevaart en defensie
Teamcenter

Hoewel de defensie-uitgaven in de EU in 2025 een recordhoogte van 418 miljard euro bereikten – een stijging van 47% sinds 2022 – en naar verwachting in 2026 zullen stijgen tot 454 miljard euro, waarschuwt het Europees Defensieagentschap (EDA) dat de tekorten aan marineschepen in Europa volgens de huidige nationale plannen waarschijnlijk niet voor 2030 zullen zijn weggewerkt.

De druk op de marinebouw om meer schepen sneller op te leveren is groter dan ooit, en het probleem is niet alleen een gebrek aan droogdokken, staal of vakbekwame lassers. Het probleem is versnippering, zowel tussen landen als binnen organisaties onderling. Vraag een scheepswerf hoe ze duizenden onderdelen, tekeningen en revisies synchroon houden tijdens een marineproject, en het antwoord loopt sterk uiteen: de ene werf gebruikt moderne scheepsbouwsoftware, de andere een verouderd PDM-systeem en een stapel spreadsheets. Zelfs binnen één werf zijn technische gegevens vaak verspreid over verschillende systemen, met een ERP-systeem dat met geen van beide communiceert.

Met een sterker streven naar Europese soevereiniteit en meer aandacht voor duurzaamheid wordt die versnippering steeds moeilijker te negeren. Digitale scheepsbouw is daardoor in hoog tempo een noodzaak geworden in plaats van een optie.


6 data-uitdagingen die de marinebouw afremmen

Staal bepaalt hoeveel een werf kan bouwen. Data bepaalt hoeveel daarvan in één keer goed wordt gebouwd. Bij marineprojecten die jaren duren, veranderen de eisen halverwege de bouw en moet elke beslissing vanaf dag één traceerbaar zijn. In zo'n omgeving blijft versnipperde data niet beperkt tot één plek. Het sijpelt door in elke fase van het project, wat leidt tot meer herstelwerk, vertragingen en langere doorlooptijden.

1. Verouderde ontwerpen op de werkvloer

Marineprojecten hebben zelden de luxe van een volledig afgerond ontwerp. Om leverdata te halen, snijden werven alvast staal voor de eerste blokken terwijl latere secties nog in de ontwerpfase zitten, en de druk om sneller te leveren vergroot die overlap alleen maar.

Wanneer technische gegevens verdeeld zijn over een verouderde PDM-tool en spreadsheets, kan niemand met zekerheid zeggen met welke revisie de productie werkt. In de praktijk kan dit betekenen dat een blok wordt uitgerust met een leidingtraject dat door de engineeringafdeling twee weken eerder al is gewijzigd.

2. Te laat ontdekte ontwerpwijzigingen

Een marineschip is een complex, nauw verweven systeem, en de eisen veranderen vaak tijdens de bouw naarmate systemen en missieprofielen worden aangepast. Vervang één onderdeel en de wijziging kan doorwerken in de constructie, het gewicht, de bekabeling, de ventilatie en de materiaallijst. Wanneer die informatie in losse bestanden staat, komen de gevolgen pas laat aan het licht, op de werkvloer, waar ze het duurst zijn om te herstellen.

3. Niet op elkaar afgestemde materiaallijsten

Engineering bepaalt waaruit het schip bestaat. ERP koopt het in, plant het en plant de tijdlijn. Wanneer deze twee niet verbonden zijn, overbruggen mensen de kloof handmatig: onderdelengegevens worden opnieuw ingevoerd, lijsten worden vergeleken en discrepanties worden nagejaagd. Bij marineapparatuur met lange levertijden kan een bestelling op basis van een verouderde revisie leiden tot maanden vertraging in plaats van dagen.

4. Goedkeuringen afhankelijk van personen

Op veel werven hangt het vrijgeven van een tekening of het goedkeuren van een onderdeel af van een paar ervaren krachten die weten hoe het proces werkt. Nu een generatie ingenieurs met pensioen gaat, vormt dit een risico voor de continuïteit. Bovendien verwachten defensieklanten dat elke beslissing traceerbaar is, iets wat een goedkeuringsproces dat verspreid is over e-mails en spreadsheets niet betrouwbaar kan bieden.

5. Verborgen kosten en ecologische voetafdruk

Het grootste deel van de kosten van een schip wordt vastgelegd tijdens het ontwerp, maar wordt vaak pas later berekend. Wanneer een leverancier te laat levert, heeft dit gevolgen voor de hele bouwvolgorde: de afbouw stagneert, blokken blijven liggen op de werf en werkzaamheden moeten worden verplaatst of in de verkeerde volgorde worden uitgevoerd tegen hogere kosten. Op de werkvloer stapelen herstelwerkzaamheden, extra arbeidsuren en spoedbestellingen zich op, zonder dat ze ooit worden herleid naar de wijziging die ze heeft veroorzaakt.

Tegen de tijd dat de werkelijke cijfers boven tafel komen, is er nauwelijks nog ruimte om bij te sturen.

6. Geen transparantie over de status van het programma

Defensieklanten verwachten regelmatige en nauwkeurige voortgangsrapportages. Wanneer gegevens versnipperd zijn, worden eenvoudige vragen lastig: wat is er vrijgegeven? Wat wacht op goedkeuring? Welke wijzigingen staan nog open?

En rapporten die handmatig zijn samengesteld uit tegenstrijdige bronnen bieden zelden het traceerbare, nauwkeurige beeld waar engineers op kunnen vertrouwen.


De digital thread: hoe digitale scheepsbouw ontwerp, productie en kosten met elkaar verbindt

Een digital thread is een continue informatiestroom die elke fase van de levenscyclus van een schip verbindt, van de eerste ontwerpbeslissing tot het opgeleverde schip. Waar een digitale tweeling het virtuele model van het schip is, zorgt de digital thread ervoor dat dat model, en elk team dat eraan werkt, wordt voorzien van nauwkeurige, traceerbare gegevens.

Door ontwerp-, engineering-, productie-, kosten- en prestatiegegevens op deze manier te verbinden, kunnen scheepsbouwers een levende digitale tweeling van elk schip creëren, de overdrachten die werven vertragen automatiseren en de controle over elke fase van de bouw behouden.

1. Ontwerp en engineering in één model

Elke wijziging die op de tekentafel wordt doorgevoerd, komt automatisch terecht in de onderdelenlijst en de productietekeningen. Geïntegreerde CAD-software maakt het mogelijk voor ontwerpers en engineers om aan hetzelfde model te werken, en ontwerpgegevens stromen door naar engineering zonder dat ze geëxporteerd, opnieuw getekend of opnieuw ingevoerd hoeven te worden. Het resultaat is minder tekenfouten en snellere ontwerpiteraties.

2. Eén bron van waarheid voor elk onderdeel en elke revisie

Elk onderdeel, elke tekening en elke revisie heeft één centrale plek, met een duidelijke status en historie. Scheepsbouw-PLM-software, gebaseerd op productlevenscyclusbeheer, beoordeelt elke wijziging aan de hand van de volledige productstructuur vóór vrijgave en leidt goedkeuringen via gestandaardiseerde workflows in plaats van via e-mailketens. Kennis blijft in het systeem behouden wanneer ervaren engineers vertrekken, en defensieklanten krijgen een volledig overzicht van wie wat wanneer heeft goedgekeurd.

3. Engineering en bedrijfsvoering in sync

Inkoop, planning en productie werken vanuit dezelfde stuklijst, zodat apparatuur met een lange levertijd op basis van de juiste revisie wordt besteld. Door PLM te koppelen aan ERP en andere bedrijfssystemen met op maat gemaakte low-code applicaties, vloeien vrijgegeven engineeringgegevens automatisch door naar inkoop en planning, en hoeft niemand handmatig onderdelenlijsten over te typen. Dat betekent minder afstemmingswerk en minder kostbare bestelfouten.

4. Een werkvloer die ziet wat engineering ziet

De werkvloer bouwt altijd op basis van het laatst vrijgegeven ontwerp, en wat daar gebeurt, vloeit terug naar de engineering. Een Manufacturing Execution System (MES) dat verbonden is met de digital thread legt voortgang, herstelwerkzaamheden en extra uren vast zodra ze zich voordoen, en biedt digitale werkinstructies en een volledig 'as-built'-dossier van elk schip. Wanneer een leverancier vertraging oploopt, kunnen plannen worden aangepast met een helder inzicht in wat dat betekent voor de rest van de bouw.

5. Kosten en CO2-voetafdruk bepaald terwijl het ontwerp nog open is

Teams zien wat een ontwerpwijziging of vertraging bij een leverancier kost voordat het de begroting raakt. Product Cost Management-software (PCM) berekent kosten en de CO2-voetafdruk terwijl het ontwerp nog open is, inclusief complexe, niet-lineaire prijsmodellen van leveranciers. Het geeft inkopers bovendien een feitelijke positie bij leveranciersonderhandelingen en een betrouwbare basis voor offertes en aanbestedingen.

6. Live inzicht in plaats van handmatige rapportages

Programmamanagers, engineers en klanten zien de werkelijke voortgang in real-time, ondersteund door data die ze kunnen traceren en vertrouwen. Een industriële IoT- en analytics-laag brengt data uit engineering, de werkvloer en de bedrijfsvoering samen in op maat gemaakte dashboards, met live inzicht in de prestaties van apparatuur en vroegtijdige waarschuwingen wanneer de productie afwijkt van de planning.

7. Intelligentie die het programma vooruithelpt

Intelligente procesorkestratie signaleert risico's vroegtijdig, anticipeert op knelpunten en coördineert de volgende stap tussen teams en systemen, zodat problemen worden opgelost voordat ze tot vertragingen leiden. En omdat het is gebouwd op dezelfde gestructureerde, traceerbare data, blijft AI beheersbaar. Elke actie wordt gelogd, de toegang volgt dezelfde rollen en rechten als de rest van de digital thread, en de orkestratie is afgestemd op de specifieke processen van elke werf. Dat maakt het 'compliant by design' en schaalbaar van een enkele workflow naar een volledig programma.


Van spreadsheets naar een digitale scheepswerf: een voorbeeld van digitale transformatie door CLEVR

Met meer dan 30 jaar ervaring in digitale transformatie ondersteunt CLEVR PLM, productieactiviteiten en applicatieprogramma's voor diverse luchtvaart-, defensie- en maritieme fabrikanten in heel Europa. Een van hen, een toonaangevende Europese scheepswerf die marine- en overheidsschepen bouwt, kampte met precies de problemen die in dit artikel worden beschreven.

Het probleem: Geen digital thread, geen traceerbaarheid

Het synchroon houden van onderdelen, tekeningen en specificaties kostte constant handmatige inspanning, releases en goedkeuringen waren afhankelijk van de kennis van individuele engineers, en de rapportagemogelijkheden waren beperkt. Met engineeringdata verspreid over een verouderd PDM-systeem en losstaande spreadsheets, en zonder koppeling met ERP, had onze klant behoefte aan een systeem dat begreep hoe een scheepswerf daadwerkelijk werkt.

Het proces: Implementatie van software voor Product Lifecycle Management in de scheepsbouw

In plaats van de digitale transformatie van de scheepswerf als een alles-in-één vervanging aan te pakken, introduceerden de consultants van CLEVR in duidelijk gedefinieerde fasen Siemens Teamcenter, een toonaangevend PLM-platform. Eerst implementeerden ze Teamcenter op de eigen servers van de werf, waardoor er vanaf dag één volledige controle was over de engineeringdata, en vervolgens configureerden ze het rond de werkelijke engineeringpraktijk. Dit betekende in kaart brengen hoe aangepaste typen en eigenschappen onderdelen, tekeningen en documenten moeten beschrijven op de manier waarop de engineers van de werf er daadwerkelijk mee werken, rollen en toegangsrechten vaststellen die bepalen wie wat kan aanmaken, wijzigen en vrijgeven, en release-workflows standaardiseren zodat elke tekening en elk onderdeel een gedefinieerde route volgt van concept tot goedkeuring.

Het resultaat: Waarde die klaar is voor schaalvergroting

Die basis is nu live: elk onderdeel, elke tekening en elke revisie heeft één centrale plek en een traceerbare historie, en goedkeuringen zijn niet langer afhankelijk van wie toevallig het proces kent. Belangrijker nog: het geeft de scheepswerf een fundament om op voort te bouwen. Geavanceerde workflows, rapportages, CAD-integratie en de koppeling met ERP worden al uitgerold, waarbij elke stap automatisering toevoegt aan gestructureerde en betrouwbare data. Zodra de keten van begin tot eind verbonden is, kan intelligentie worden toegevoegd om problemen te voorzien, werk tussen teams te coördineren en de werf te helpen sneller te groeien naarmate de programma's groter worden.


CLEVR: Uw partner voor digitale transformatie in de scheepsbouw

Dit is de ware kracht van de CLEVR-methodologie.

In plaats van een standaardtemplate op te leggen, nemen onze consultants de tijd om te begrijpen hoe elke scheepswerf zijn schepen ontwerpt, en configureren we het systeem daarop. We werken in fasen, zodat elke stap iets bruikbaars oplevert voordat de volgende begint, en we werken vanaf dag één nauw samen met de teams van onze klanten. We bouwen oude integraties niet simpelweg na; we ontwerpen vanaf het begin met minder handmatige stappen in gedachten. Dat is wat een software-implementatie verandert in een verandering die engineers echt merken in hun dagelijkse werk.

Wilt u zien hoe een verbonden digital thread uw scheepswerf kan helpen om de groeiende vraag om te zetten in tijdige levering van schepen? Neem contact op met CLEVR voor een adviesgesprek.

november 2, 2026 9:06 AM

Frequently Asked Questions

1

What does PLM stand for?

PLM stands for Product Lifecycle Management.

2

What are the steps in the PLM process?

The PLM process is divided into five main stages: Conception, Design and Engineering, Manufacturing, Commissioning, and Decommissioning.

3

What is a PLM strategy?

A PLM strategy is a strategic approach to developing, managing, and improving products from conception to disposal. It creates a framework that blends existing procedures, individual expertise, and technology to enhance product quality, reduce costs, and accelerate time to market.

4

What is the difference between PLM and PDM?

PDM (Product Data Management) is a key component within the broader PLM system. While PDM focuses specifically on centralizing and managing product-related data (such as version control and access permissions), PLM is the overarching system that manages the entire product lifecycle and all associated processes.

5

What is the difference between ALM and PLM?

The primary difference lies in the nature of the product being managed: PLM is designed for the development of physical products and manufacturing processes, handling everything from initial conception and manufacturing specifications to decommissioning. In contrast, ALM (Application Lifecycle Management) is focused on the development of software applications and digital systems.

While both share core management principles, their applications differ significantly. For example, PLM stages include complex physical requirements like prototyping, mass-production scaling, and environmental decommissioning, whereas ALM focuses on code iterations and software releases. Consequently, PLM requires its own specialized toolset (like Siemens Teamcenter), though agile ALM tools and low-code platforms can be adapted to extend and optimize these PLM processes.

Contact us

Want to know how our solutions, products, and services can accelerate your digital transformation? 

Want to know how our solutions, products, and services can accelerate your digital transformation?